目录
一、介绍
1.1 SIFT算法
SIFT(Scale invariant feature transform)是尺度不变特征变换,是一种用来检测和描述图像局部特征的算法。算法实际上是要在不同尺度空间中寻找极值点,并提取其位置、尺度和旋转不变量,这些关键点不会因光照、仿射变换和噪音而变化。
1.2 SIFT特征的获取方法
-
尺度空间极值检测
利用高斯差分函数搜索所有尺度和图像位置,找到对尺度和方向不变的候选关键点。
-
关键点定位
对每一个候选关键点都需要确定其位置和尺度,并要保证其稳定性。
-
方向分配
根据局部图像的梯度方向,为每个关键点分配一个或多个方向。
-
关键点描述
在每个关键点周围区域的选定尺度上测量局部图像的梯度,这些信息表示了允许的局部形状失真和光照变化。
1.3 图像匹配和识别的方法
- 先从一组目标物体的参考图像中提取SIFT特征并存储在数据库。
- 将新图像的每个特征与之前的数据库逐一比较,根据特征向量的欧几里得距离找到匹配特征。
1.4 如何提高匹配准确率
-
利用识别与新图像中对象的位置、比例和方向一致的关键点子集,可以在匹配集中过滤出正确的匹配。几个特征共同作为判断依据匹配出错率远小于单一特征匹配。
-
匹配方法
①先对物体姿态的放射近似作最小二乘估计,与此姿态一致的其它图像特征被识别出来,异常值被丢弃。
②给出你和的准确性和可能的错误匹配的数量,对一组特征表明对象存在的概率进行详细计算。
③通过所有测试的对象匹配可被标为正确且具有高可信度。
二、尺度空间极值检测
SIFT算法是在不同的尺度空间上查找关键点,尺度空间的获取需要使用高斯模糊。
2.1 高斯模糊
(1)高斯函数
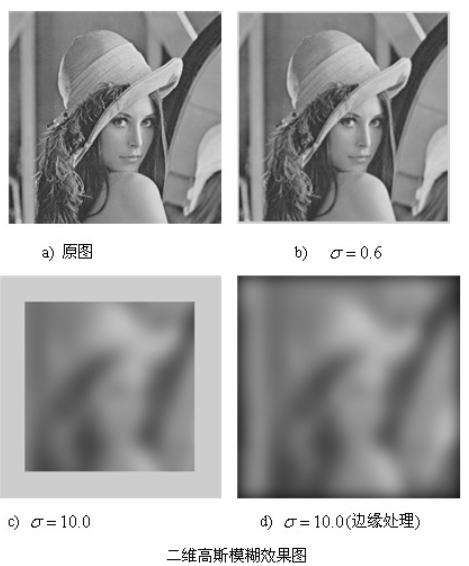
高斯模糊使用高斯函数(正态分布)计算模糊模板,并使用该模板与原图像做卷积运算,以此模糊图像。
N维空间的高斯计算公示:
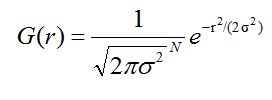
- 为正态分布的标准差,越大图像越模糊、越平滑
- 为模糊半径,指模板元素到模板中心的距离
二维空间的高斯计算公式:

- 为正态分布的标准差,越大图像越模糊、越平滑
- m,n为二维模板的大小m*n
- x,y为模板上元素的位置(x,y)
二维高斯函数生成的曲面是从中心开始的正态分布同心圆。每个像素的值都是周围相邻像素的加权平均。原始像素具有最大的权重,边缘像素权重越来越小,因此更高的保留了边缘效果。
在计算每个像素的离散近似时,之外的像素都可以视为不起作用,因此图像处理程序只需要计算 的矩阵就可以了。
(2)二维高斯模糊
根据计算出高斯模板矩阵(大小为,值根据计算)
对高斯模板矩阵进行归一化处理(确保矩阵元素在范围内),例如的高斯模板如下图,可以看出高斯模板是中心对称的。
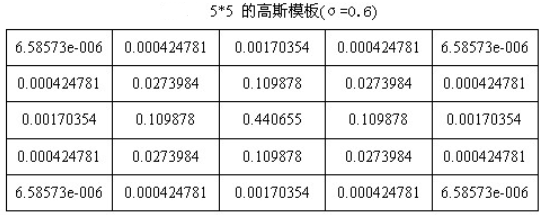
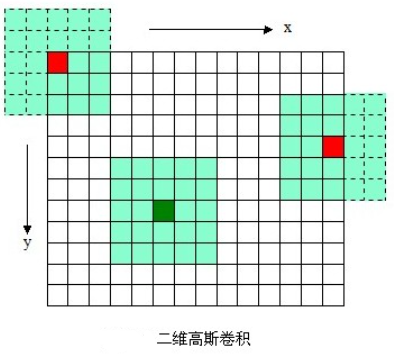
利用此高斯模板矩阵与原图像做卷积,即可获得原图像的高斯模糊图像。卷积过程示意图如下:
(3)分离高斯模糊
二维高斯模糊有两个不足之处:
- 使用二维高斯模糊会造成边缘图像缺失,越大,缺失像素越多
- 模板变大时,高斯核的卷据运算量会大幅度提高
解决方法:
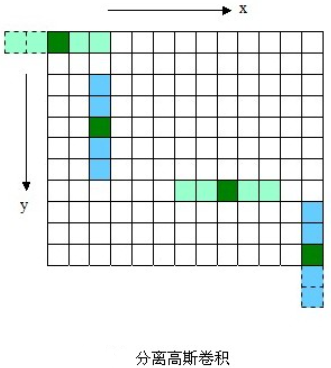
利用高斯函数的可分离性(二维矩阵的变换效果等效于水平方向一维高斯矩阵变换加竖直方向一维高斯矩阵变换)。
- 两次一维的高斯卷积将消除二维高斯矩阵所产生的边缘。
- 卷积运算只需要O(n×M×N)+O(m×M×N)次计算,而二维矩阵需要O(m×n×M×N)次计算。其中m,n为高斯矩阵的维数。M,N为二维图像的维数。
2.2 尺度空间
(1)尺度空间的概念
-
概念
在图像信息处理模型中引入一个被视为尺度的参数,通过连续变化尺度参数获得多尺度下的尺度空间表示序列,对这些序列进行尺度空间主轮廓的提取,并以该主轮廓作为特征向量,实现边缘、角点检测和不同分辨率的特征提取。
-
特点
将传统的但尺度图像信息处理技术纳入尺度不断变化的动态分析框架中。更容易获取图像的本质特征。尺度空间中各尺度图像的模糊程度逐渐变大,能够模拟人在距离目标由近到远时目标在视网膜上的形成过程。
-
优点
1)尺度空间算子对图像的分析不受图像的灰度水平和对比度变化的影响,即满足灰度不变性和对比度不变性;
2)尺度空间算子对图像的分析和图像的位置、大小、角度以及仿射变换无关,即满足平移不变性、尺度不变性、欧几里德不变性以及仿射不变性。
(2)尺度空间的表示
尺度空间 定义为变化尺度的高斯函数 与原图像 的卷积。

其中为尺度因子,越小对应模糊程度越小,相应的尺度约小。因此大尺度对应图像的概貌特征,小尺度对应图像的细节特征。
(3)高斯金字塔的构建方法
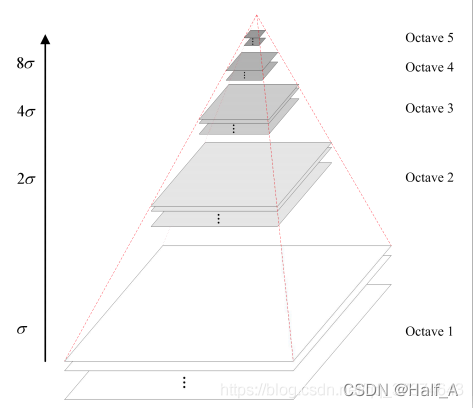
尺度空间在实现时使用高斯金字塔表示,高斯金字塔构建分为两步:1)对图像做降采样;2)对图像做高斯平滑。
金字塔模型是指将原始图像不断进行降采样,得到一系列大小不同的图像,由大到小,由下到上。原图像为金字塔的第一层,每次降采样所得到的新图像为金字塔的一层。为了让尺度体现其连续性,高斯金字塔在简单降采样的基础上加上了高斯滤波。
如上图所示,将图像金字塔每层的一张图像使用不同参数做高斯模糊,Octave表示一幅图像可产生的图像组数,Interval表示一组图像包括的图像层数。另外,降采样时,高斯金字塔上一组图像的初始图像(底层图像)是由前一组图像的倒数第三张图像隔点采样得到的。
高斯金字塔的层数计算:
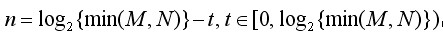
M,N:原图像大小 t:塔顶图像的最小维度的对数值

2.4 极值检测方法
由于要在尺度空间中寻找图像的极值点,因此在实际计算中,使用高斯金字塔每组中相邻上下两层图像相减,得到高斯差分图像(Difference of Gaussian ,简称DOG),进行极值检测。即两个相邻尺度的差(这里用常数k区分相邻的尺度):
为了寻找高斯差分函数函数的极值点,每一个像素点要和它所有的相邻点比较,看其是否比它的图像域和尺度域的相邻点大或者小。如图所示,中间的检测点和它同尺度的8个相邻点和上下相邻尺度对应的9×2个点共26个点比较,以确保在尺度空间和二维图像空间都检测到极值点。
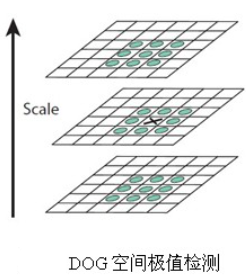
由于要在相邻尺度进行比较,由于高斯差分金字塔的每一组图像,只能在中间的层进行极值点检测,最上和最下层无法进行。
为了在每组中检测S个尺度的极值点,则DOG金字塔每组需S+2层图像,而DOG金字塔由高斯金字塔相邻两层相减得到,则高斯金字塔每组需S+3层图像,实际计算时S在3到5之间。
2.5 极值检测的采样频率
检测局部极大值和极小值,在采样点同层的8个邻域点和上下相邻层的各9个邻域点之中选择,只有大于或这些所有的邻域点才能称为极值。经过检测后绝大多数的采样点都被剔除了。
其中重要问题就是确定图像和尺度的采样频率,以可靠的检测极值,但事实上极值点可以非常接近,因此需要找到一种平衡效率和完整性的解决方案。
(1)尺度域的采样频率
经过大量实验数据得到:
(1)当采样更多尺度时,可重复性没有继续提高,因为这会导致更多的局部极值被检测到,但这些极值平均来说不太稳定,不太可能在被转换后的图像中检测到。
(2)当采样规模增大时,关键点的数量增加,正确匹配的总数量增加,由于实际使用时物体识别的成功更多取决于正确匹配关键点的数量,而不是正确匹配的百分比,因此使用大量的样本是最好的。但是这会导致计算成本的增加,所以Lowe建议每组使用3个尺度样本
(2)空间域的采样频率
需要确定在一个尺度内图像域的采样频率,假设极值点可以任意靠近,那么在空间域的采样频率和检测率之间也会有类似的平衡。这里Lowe经过实验,建议选择使用。
并且由于在进行极值检测之前进行了差分处理,因此丢弃了最高的空间频率,为了充分利用输入,可以在构建金字塔第一级之前使用线性插值将输入图像的大小增加一倍。
三、关键点定位
3.1 关键点的准确定位
离散空间的极值点不是图像真正的极值点。
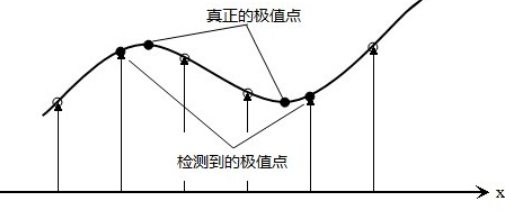
为了提高关键点的稳定性,需要对尺度空间函数进行曲线拟合。利用尺度空间函数的Taylor展开式,导数在极值点处为0,求得的偏移量实现对关键点的精确定位。
将尺度空间函数进行泰勒展开,使原点与采样点重合。
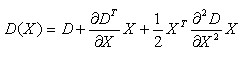
对求导并令其等于零,求得即为的偏移量。
3.1 消除边缘响应
为了稳定,仅去除低对比度的关键点是不够的,还需要消除高斯差分函数带来的边缘响应。在边缘梯度方向的主曲率较大,垂直方向(沿边缘方向)的主曲率较小。主曲率可以通过Hessian矩阵计算:
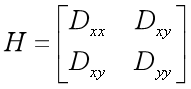
其特征值正比于D的主曲率,由于我们只需要特征值的比值,因此可以避免求出特征值的结果。设为较大的特征值,为较小的特征值,取,利用迹和行列式的特点:
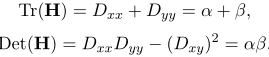
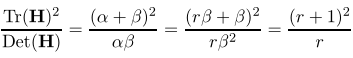
因此当两特征值相等时,上式有最小值,并且该式随着比值增大而增大,因此要检验主曲率是否在某个阈值以下,只需要检验
。当满足条件时保留特征点,否则剔除。(常用T=1.2)
四、梯度方向分配
4.1 梯度大小方向求解
为了使关键点描述子具有旋转不变性,利用图像的局部特征给每一个关键点分配一个基准方向,使描述子对图像旋转具有不变性。对于在高斯差分金字塔中检测出的关键点,采集其所在高斯金字塔图像邻域窗口的像素的梯度和方向分布特征。梯度的模和方向如下:
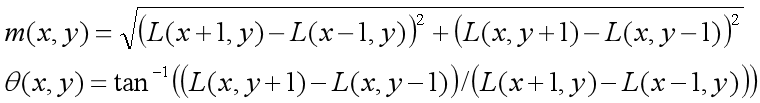
4.2 梯度统计
完成关键点的梯度计算后,使用直方图统计邻域内像素的梯度和方向。梯度直方图将0~360°方向分为36份,每个柱子代表10°范围,如图直方图的峰值代表关键点的主方向。
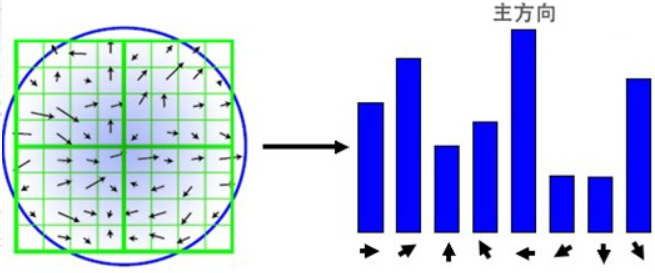
以直方图中最大值作为该关键点的主方向,为了增强匹配的鲁棒性,只保留峰值大于主方向峰值80%的方向作为该关键点的辅方向。
五、关键点描述子
经过上面的步骤,每一个关键点都拥有位置、尺度、方向三个信息。
下一步是为每个关键点建立一个描述符,用一组向量将这个关键点描述出来,使其不随各种变化而改变,使其不随光照、视角等变化而变化。
5.1 描述符表示
(1)特征向量表示
首先在关键点周围采样图像的梯度大小和方向,利用关键点的尺度选择图像的高斯模糊程度。为了实现方向不变性,描述子的坐标和梯度方向是相对于关键点方向旋转的。
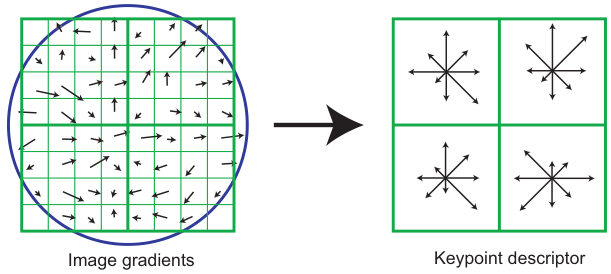
使用一个等于子窗口宽度的一半的高斯加权函数来为每个采样点的大小赋值。(为了避免随着窗口位置的微小变化导致的描述符的突然变化,同时减少远离描述符中心的梯度影响,这些梯度最容易配准错误)
描述符由一个包含所有方向直方图条目值的向量构成,Lowe经过实验证明最好的选择是:每个关键点划分4个领域,对应4个描述子,每个描述子使用4x4的方向直方图阵列,每个直方图中有8个梯度方向,因此每个关键点采用4x4x8=128个特征向量。
(2)归一化处理
对特征向量进行修正,减小光照变化对特征向量的影响。
- 对比度影响消除
因为图像对比度的变化即每个像素值乘以一个常数,因此归一化会消除对比度的影响。
因此首先将向量归一化为单位长度。
- 照明条件影响消除
图像亮度是每个图像像素加上一个常数,因此亮度变化不会影响图像的梯度,所以描述符对于光照的仿射变化是不变的。(在不考虑非线性光照的情况下)
考虑照明条件变化,可以通过将单位特征向量阈值划为不大于0.2(Lowe实验测得),减少较大梯度的影响,然后重新归一化。此时匹配大梯度不再重要,方向的分布更加重要。
六、物体识别的应用
目标识别首先通过将每个关键点独立地与从训练图像中提取出的关键点数据库进行匹配来完成。由于模糊的特征和背景影响,一开始匹配肯定是不准确的。所以需要至少有三个特征的聚类首先被识别出来,这些聚类与对象姿态一致,其正确性就比单个特征匹配要高得多。然后对每个聚类进行几何拟合检查,根据拟合结果接受或拒绝。
- 从训练图像中识别关键点数据库中的最近邻,找到每个关键点的最佳候选匹配。(最近邻可以使用最小欧式距离)
- 如果图像特征在数据库中没有任何正确的匹配,则丢弃。
- 如果有多个匹配结果,则定义第二个最近邻为已知来自不同物体。在相似距离内可能会有许多其他错误匹配。我们可以将次近匹配视为在特征空间的这一部分内提供错误匹配密度的估计。
七、总结
SIFT特征具有稳定性和不变性,在图像处理和计算机视觉领域有着很重要的作用。
SIFT算法的主要实现过程
-
尺度空间极值检测
-
关键点定位
-
方向分配
-
关键点描述和匹配
评论